 GETPROFF
У большинства экспертов и онлайн-школ знания уже накоплены: записи уроков и вебинаров, презентации, регламенты, статьи, переписки с клиентами. Но лежат они вперемешку. Человек тратит минуты на поиск нужного момента в двухчасовой записи, а ИИ-агент не начнёт отвечать «по вашим материалам» только потому, что ему показали папку.
Чтобы агент отвечал точно, материалы нужно превратить в базу знаний: получить из видео текст, очистить его, разложить по темам, разбить на смысловые фрагменты и настроить поиск. В статье разберём весь путь по шагам, покажем, как он выглядит на практике, где обязательно нужен человек и как проверять качество. Обещать абсолютную точность мы не будем: RAG снижает риск выдуманных ответов, но не отменяет контроль.
Что такое база знаний для ИИ и чем она отличается от папки с файлами
База знаний для ИИ-агента — это управляемый набор проверенных материалов. У каждого фрагмента есть смысл, источник, дата актуальности и правила доступа, а поиск по такой базе возвращает агенту нужный контекст для ответа. Папка с файлами — это склад: агент не знает, какой документ свежий, какой черновой и в какой минуте видео лежит ответ на вопрос про возврат оплаты.
Разница проявляется в пяти вещах:
- Текст. В папке видео остаётся видео, а в базе знаний у него есть текст, по которому можно искать.
- Структура. В папке материалы лежат как попало, а в базе разложены по аудиториям, продуктам, процессам, методам и фактам.
- Актуальность. В папке нет статуса и даты, а в базе видно, что свежее, что устарело и кто за это отвечает.
- Доступ. В папке доступ открыт или закрыт целиком, а в базе можно решить, какие знания видит агент, а какие остаются только для сотрудников.
- Проверяемость. В папке непонятно, откуда взялся ответ, а в базе к ответу можно привязать источник.
Два термина, чтобы не путаться. ИИ-ассистент обычно отвечает на запросы пользователя. ИИ-агент ведёт диалог по правилам, использует знания и инструменты и умеет передать случай человеку. Для базы знаний разница невелика: обоим нужен один источник истины. Важнее другое разделение. Инструкция агента определяет, как он себя ведёт: тон, порядок вопросов, ограничения, момент передачи человеку. База знаний определяет, на что он может опираться: регламенты, описания продуктов, методики, ответы на частые вопросы.
Как создать базу знаний для ИИ-агента: короткий маршрут
- Определите задачу: на какие вопросы агент должен отвечать и кому.
- Соберите источники и отберите то, что можно считать достоверным.
- Получите текст из видео и аудио: распознайте речь.
- Очистите текст и разложите его по структуре: аудитории, продукты, процессы, методы, факты.
- Разбейте материал на смысловые фрагменты и проиндексируйте их для поиска.
- Подключите базу к агенту, прогоните тестовые вопросы, назначьте владельца обновлений и канал передачи человеку.
Дальше пройдём каждый шаг подробно.
Какие источники использовать: видео, транскрибации, инструкции, статьи, записи встреч и регламенты
Начинайте не с «всего, что есть», а с материалов, которые отвечают на реальные вопросы клиентов и учеников. Хороший источник должен быть достоверным, понятным без картинки на экране и иметь ответственного. Подходят:
- Видео уроков и вебинаров. Самый богатый источник экспертной логики: объяснения, примеры, ответы на вопросы. Но для поиска нужен текст.
- Транскрибации. Текст, полученный из видео и аудио. Именно он становится материалом базы знаний.
- Инструкции и регламенты. Как оформить заказ, выдать доступ, вернуть оплату, передать обращение специалисту.
- Статьи и страницы сайта. Опубликованные описания продуктов и методов, которые уже прошли редактуру.
- Записи встреч и созвонов. Полезны для внутренней базы, если из них убрать персональные данные и разговоры не по теме.
- Ответы на частые вопросы. Проверенные формулировки из поддержки: то, что вы уже много раз отвечали клиентам.
Чего лучше не брать без разбора: черновики, устаревшие прайсы, противоречащие друг другу версии программы, личные переписки и материалы с персональными данными. Если в базе лежат две версии цены, агент рано или поздно назовёт неправильную. ИИ не понимает, какая из них «настоящая»: это решает человек, который отвечает за информацию.
Собирать самому или взять готовую среду
Здесь стоит выбрать подход, а не инструмент. Путей три.
Первый — собрать контур самостоятельно: сервис распознавания речи, хранилище файлов, векторный индекс, серверная часть, чат-интерфейс, подключение мессенджеров. Код для этого можно писать с помощью coding-агентов вроде Codex или Claude Code, и для команды с разработчиком это нормальный путь с полным контролем. Но между сгенерированным кодом и работающим продуктом остаются хостинг, база данных, формы, автоматизации, публикация, права доступа и поддержка. Эту разницу мы подробно разбирали в статье про инфраструктуру для бизнеса при работе с Claude Code и Codex. Доступность зарубежных сервисов и способы оплаты меняются, поэтому проверяйте их на момент подключения, а не по старым обзорам.
Второй — модуль базы знаний внутри чат-платформы. Это быстро, но заранее проверьте, можно ли использовать те же материалы вне платформы: для сайта, обучения и внутренних интерфейсов.
Третий — среда, где хранилище файлов, распознавание речи, база знаний, агент и каналы связи находятся рядом. Так устроен Chatium: вы храните видео, получаете из него текст, собираете структурированную базу и подключаете её к агенту в одном рабочем пространстве. Сайт, форма, CRM и уведомления для передачи человеку строятся там же. Этот путь подходит эксперту, школе или руководителю поддержки, которым нужен работающий результат, а не собственный DevOps. Если же нужна сложная кастомная логика или высокие нагрузки, без разработчика по-прежнему не обойтись.
Практический путь в Chatium: загрузить видео в файловое хранилище и распознать речь
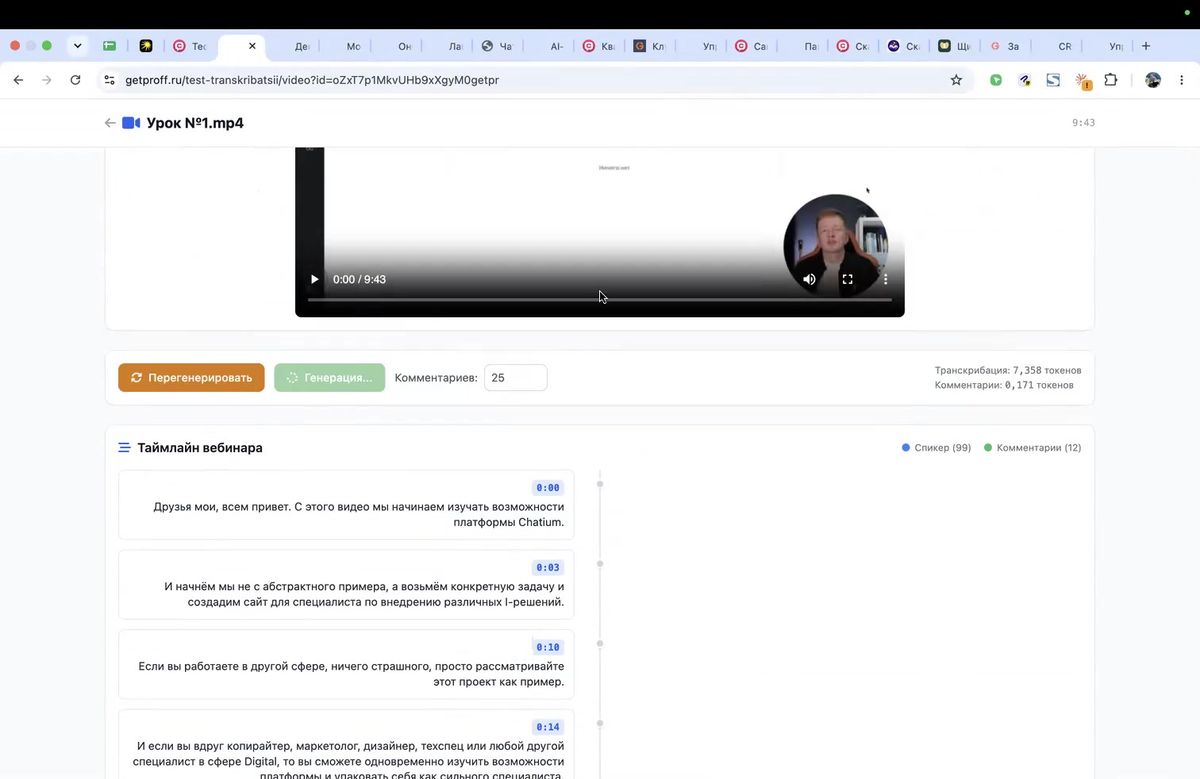
Сначала важное уточнение. ИИ-модель не смотрит исходный видеофайл при ответе на вопрос. Для текстового поиска нужен извлечённый текст, то есть транскрибация. Видео остаётся исходником и доказательством, а искать и цитировать агент будет по тексту.
Рабочий порядок в Chatium такой:
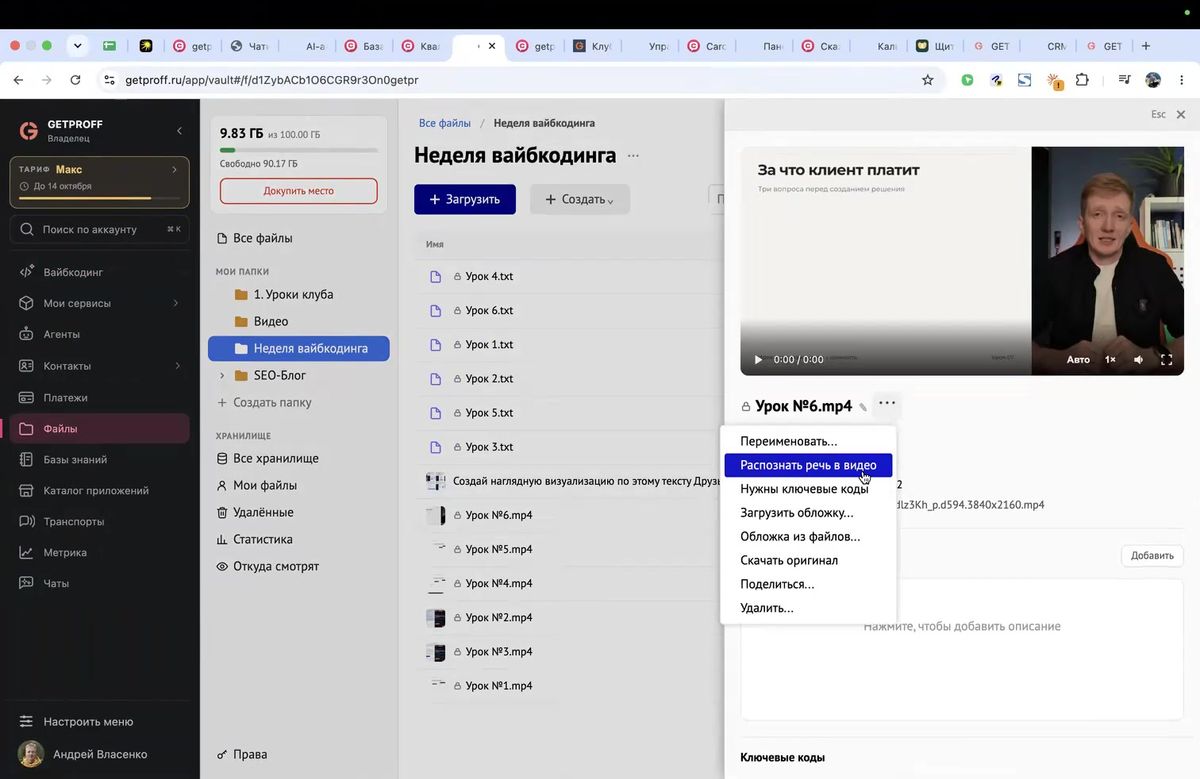
- Загрузите видео в файловое хранилище. Заранее продумайте папки: по продуктам, курсам или потокам. Через месяц вы скажете себе спасибо за понятные названия.
- Откройте видео и запустите команду распознавания речи. Система превратит звук в текст.
- Дождитесь результата: текст появится рядом с видео, его можно открыть, прочитать и использовать дальше.
- Прочитайте транскрибацию целиком, хотя бы по диагонали. Исправьте имена, названия продуктов, суммы, даты и профессиональные термины: именно на них распознавание речи ошибается чаще всего.
- Сохраните проверенный текст в отдельную папку транскрибаций и привяжите к исходному видео.
Публичных подробностей о том, как именно устроено распознавание внутри платформы, немного, поэтому не рассчитывайте на идеальную точность. Качество зависит от записи: шум, акцент, быстрая речь, узкие термины и перебивания снижают результат в любой системе. Считайте распознавание черновиком, который вы вычитываете.
Файловое хранилище здесь важнее, чем кажется. Оно объединяет исходники, тексты и то, что вы будете с ними делать дальше. В LMS в Chatium тот же видеофайл выбирают для урока прямо из хранилища, а транскрибацию можно превратить в текстовое описание урока. Один раз вычитанный текст работает трижды: как материал для агента, как конспект урока и как заготовка для статьи. Так вы не делаете одну и ту же работу заново в разных местах.
Если бы вы собирали похожий контур из разрозненных сервисов, вам понадобились бы отдельное хранилище, отдельный распознаватель, отдельная база и отдельный агент со своими интеграциями. В Чатиум эти части находятся в одном проекте, поэтому вместо сборки инфраструктуры вы занимаетесь содержанием базы, а от него зависит качество ответов.
Можно ли сделать базу знаний из видео?
Можно, но не напрямую. Видео нужно превратить в текст, затем текст очистить, структурировать и проиндексировать. Именно так и получается база знаний из видео: путь «видео → транскрибация → структура → фрагменты → поиск → ответ со ссылкой на источник». Пропустите очистку — и агент будет цитировать оговорки, реплики вроде «вот здесь на слайде видите» и ошибки распознавания.
Как транскрибировать видео нейросетью, если вы работаете не в Chatium
Нейросетей для транскрибации видео в текст в 2026 году несколько, и различаются они заметно. Обзор популярных сервисов есть, например, в подборке Sostav о транскрибаторах на 2026 год. Цены и лимиты быстро меняются, поэтому проверяйте актуальные условия на сайте самого сервиса. Выбирая инструмент, сравнивайте по критериям:
- качество распознавания русской речи и ваших специальных терминов на пробном фрагменте;
- таймкоды: с ними ответ можно привязать к месту в видео;
- разделение спикеров, если это вебинар или запись встречи;
- формат экспорта, чтобы текст было удобно править и переносить;
- лимиты на длину файла и объём в месяц;
- условия обработки данных: куда уходит файл и как долго хранится.
Вопрос «транскрибация видео нейросеть бесплатно» встречается часто. Бесплатные тарифы обычно ограничены по длине записи, количеству файлов или функциям, поэтому пробуйте сервис на одном уроке и смотрите, хватает ли лимитов для вашего архива. Материалы с персональными данными клиентов не загружайте в сервис, условия которого вы не проверили.
Как очистить и структурировать сырой материал: аудитории, продукты, процессы, методы, факты
Сырая транскрибация — это живая речь: повторы, слова-паразиты, отступления, отсылки к экрану, оговорки. Для человека, который смотрит урок, это нормально. Для базы знаний — шум, а шум снижает точность поиска. Поэтому следующий шаг — очистка и перекладка в понятную структуру.
Что убрать или исправить:
- слова-паразиты, повторы и незаконченные фразы;
- отсылки к картинке («вот здесь видите», «на этом слайде»): либо заменить пояснением, либо удалить;
- лирические отступления, не относящиеся к теме раздела;
- ошибки распознавания в именах, названиях, суммах и терминах;
- устаревшие данные: старые цены, закрытые потоки, прежние условия.
Затем раскладываем материал по пяти типам. Так знания удобно искать и поддерживать:
- Аудитории. Кому вы помогаете, какие у людей задачи, страхи и критерии выбора. Например, у образовательного проекта это могут быть родители, помогающие специалисты и люди, меняющие профессию. Каждому сегменту нужен свой раздел.
- Продукты. Что входит, для кого подходит, что не входит, сроки, условия, форматы.
- Процессы. Как получить доступ, оформить возврат, записаться, передать вопрос специалисту: по шагам и без двусмысленностей.
- Методы. Описание подхода, этапы, ключевые понятия и определения: в терминах, которыми пользуетесь вы.
- Факты. Цены, даты, лимиты, контакты, обязательные условия. Для них важнее всего дата актуальности и владелец.
Такую перекладку можно поручить нейросети. В Chatium это делают в рабочем пространстве с помощью встроенного ИИ-помощника Ботана: загружаете транскрибации, описываете нужную структуру (целевая аудитория, описание метода, эксперты, школы, флагманские продукты) и просите превратить хаос в понятные инструкции. На выходе получается материал, разложенный по сегментам и написанный так, чтобы агенту было удобно в нём ориентироваться. Часто это работает лучше, чем структура, которая кажется логичной человеку, но неудобна для поиска.
Чтобы база была управляемой, у каждого раздела должна быть небольшая карточка:
- название и тип (аудитория, продукт, процесс, метод, факт);
- источник: видео, документ или страница, лучше с таймкодом;
- дата последнего обновления;
- статус: актуально, на проверке, устарело;
- ответственный за содержание;
- доступ: публичный, только для агента или только для сотрудников.
Последний пункт важен для разделения знаний. Базу можно сделать публичной или закрытой и давать агентам доступ к ней выборочно. Например, база о продукте доступна консультанту, а внутренние инструкции для сотрудников лежат в отдельной базе, куда агент не заходит.
Смысловые фрагменты и индексация: почему агенту передают несколько отрывков, а не весь архив
Очевидная мысль: раз у нас есть все материалы, давайте отдадим их агенту целиком. Так не работает по трём причинам. У модели ограничен объём контекста. Чем больше лишнего в контексте, тем выше риск, что она зацепится за нерелевантное. И чем длиннее контекст, тем дороже и медленнее каждый ответ.
Решение — чанкинг: разбиение материала на смысловые фрагменты. Хороший фрагмент — это законченная мысль, которую можно прочитать отдельно и понять, о чём она: один ответ, одно определение, один шаг процесса. Не «каждые N символов», а «до конца мысли».
Дальше включается индексация. Каждый фрагмент переводится в эмбеддинг: числовое представление смысла. Эмбеддинги хранятся в векторном индексе. Когда приходит вопрос, он тоже превращается в вектор, и система находит фрагменты, наиболее близкие по смыслу. Это и есть семантический поиск: вопрос «как вернуть деньги, если не подошло» найдёт раздел «Условия возврата», даже если слова «вернуть деньги» там не встречаются. Общая схема подробно описана в материале IBM про retrieval augmented generation.
Что делает фрагмент хорошим:
- Одна тема. Не смешивайте цены, методику и порядок оплаты в одном куске.
- Самодостаточность. В начале указано, о чём речь: не «это входит в тариф», а «В тариф „Базовый“ входит…».
- Заголовок и метки. Название раздела, продукт, аудитория и статус помогают фильтровать и уточнять поиск.
- Целостность. Таблицу тарифов и пошаговую инструкцию не режут посередине.
- Небольшое пересечение соседних фрагментов, если мысль переходит из одного в другой.
Типичные ошибки: слишком мелкие куски, в которых нет контекста; слишком крупные, где на один вопрос приходится полстраницы лишнего; и «висячие» фрагменты вроде «да, конечно, это возможно» без указания, что именно возможно.
Как работает RAG: вопрос, поиск, подбор контекста, ответ и ссылка на источник
RAG (retrieval augmented generation, «генерация, дополненная поиском») — способ, при котором система сначала ищет релевантные фрагменты в вашей базе, добавляет их в контекст модели и только потом просит сформулировать ответ. Проще говоря: перед тем как сотрудник ответит клиенту, ему кладут на стол три нужные страницы регламента. Отвечать он будет по ним, а не по памяти.
- Вопрос. Клиент пишет в чат: «Можно ли оплатить курс в рассрочку и что будет, если я не успею закончить?»
- Поиск. Система превращает вопрос в вектор и находит в индексе близкие по смыслу фрагменты: об оплате и о сроках доступа.
- Подбор контекста. Выбираются несколько лучших фрагментов, а не весь архив. При необходимости фильтруются по продукту, аудитории и статусу актуальности.
- Ответ. Модель получает вопрос, инструкцию агента и найденные фрагменты, после чего формулирует ответ на их основе.
- Ссылка на источник. К ответу привязывается, из какого материала взята информация, чтобы человек мог проверить, а вы разобрать диалог.
Как ИИ-агент выбирает нужный источник?
Он не «помнит» ваш архив, а получает набор кандидатов от поискового слоя. Поиск ранжирует фрагменты по близости к вопросу, а метаданные помогают сузить выбор: показывать только актуальные материалы, только по нужному продукту, только из доступных агенту баз. Поэтому качество ответа зависит от трёх вещей: как размечена база, как разбита на фрагменты и как сформулирована инструкция агента.
Отдельно проговорите в инструкции, что делать, если подходящего фрагмента нет. Правильное поведение такое: честно сказать, что в материалах этого нет, при необходимости собрать контакт и передать вопрос человеку. Не просите агента «додумать» цену, срок или условие. Уверенный, но выдуманный ответ хуже честного «не знаю».
И ещё раз без иллюзий. RAG сильно повышает шансы, что ответ опирается на ваши материалы, но не гарантирует безошибочность. Модель может неверно истолковать фрагмент, а поиск — принести не то. Поэтому дальше речь пойдёт о контроле.
Одна база знаний для нескольких агентов и транспортов: сайт, Telegram, MAX, email и внутренние интерфейсы
Один из главных плюсов управляемой базы — её можно подключить к нескольким агентам и каналам. Полезно различать три сущности. Канал — то, с чем контактирует клиент: Telegram-бот, веб-чат на сайте, MAX. Транспорт — техническое подключение канала к платформе. Агент — логика, знания и стиль общения.
Из этого следует практический вывод: знания и правила настраиваются один раз, а транспортов может быть много. Клиент пишет в Telegram, другой человек — в веб-чат на сайте, третий — в MAX, и все они попадают к одному агенту с одной базой. Если вы поправили ошибку в базе, исправление сразу работает во всех каналах. Не нужно обновлять пять копий инструкций.
Ответ на вопрос «можно ли подключить одну базу к нескольким агентам» — да, при этом полезно разделять роли. Консультанту по продуктам нужны описания и условия. Агенту поддержки — процессы и решения типовых проблем. Внутреннему помощнику для команды — инструкции и регламенты, которые клиентам показывать нельзя. Разные базы и разные права доступа позволяют держать эти границы.
Ещё одна практика: не превращать инструкцию агента в огромное полотно. Если всё содержание запихнуть в инструкцию, оно будет каждый раз попадать в контекст целиком, а качество ответов со временем снижается. Лучше держать инструкцию короткой (роль, тон, порядок вопросов, ограничения, передача человеку), а знания хранить в базе и подтягивать по запросу. Для сложных процессов используют отдельных агентов под руководством главного: каждый работает со своим набором знаний.
Как подключить готовую базу к агенту и Telegram, разобрано в пошаговом уроке про создание ИИ-агента-консультанта в Chatium. Там же показано, как администратор смотрит цепочки диалогов и журнал обработки. Когда база готова, следующий шаг — открыть в Chatium агента, выбрать для него базу знаний и связать с каналом: логика агента, знания и транспорт настраиваются в одном месте, и заменить канал можно, не переписывая инструкцию.
Где нужен человек: медицина, право, финансы, конфликтующие данные и низкая уверенность
Автономный агент не отменяет ответственность бизнеса. Ответы, которые формирует ИИ, — это ваши ответы клиенту. Есть ситуации, где человек нужен всегда, и их лучше прописать в инструкции заранее.
Какие данные нельзя отдавать агенту без проверки человека и в каких случаях диалог надо передавать специалисту:
- Медицина. Диагнозы, лекарства, схемы лечения, рекомендации, которые могут повлиять на здоровье.
- Право. Толкование договоров, оферты, претензии, юридические последствия.
- Финансы. Возвраты, нестандартные скидки, рассрочки, крупные суммы, налоговые вопросы.
- Конфликтующие данные. Если в найденных фрагментах два разных ответа, агент не выбирает сам.
- Низкая уверенность. Поиск ничего подходящего не вернул или ответ опирается на слабое совпадение.
- Жалобы, эмоции, повторное непонимание. Человеку виднее, как разрядить ситуацию.
Это не абстрактный риск. В одном из проектов в сфере здоровья агент во время наблюдения за диалогом начал рекомендовать человеку мазь и объяснять, как её наносить. Ошибку вовремя заметили и остановили, но урок очевиден: особенно на старте агента нужно наблюдать и докручивать. В таких темах инструкция должна прямо запрещать рекомендации по лечению и требовать передачи специалисту.
Канал эскалации — обязательная часть базы знаний, а не приложение к ней. Он должен отвечать на четыре вопроса:
- Кто получает передачу: конкретный человек или команда, а не «кто-нибудь».
- Что агент делает в момент передачи: сообщает клиенту, что подключит специалиста, собирает суть вопроса и контакт.
- Как человек узнаёт об обращении: уведомление в мессенджере, задача в CRM или письмо.
- Что происходит после подключения человека: агент ставится на паузу, чтобы не отвечать параллельно.
Отдельно про данные. В базу знаний не нужно класть персональные данные клиентов, пароли, реквизиты и договоры с конфиденциальными условиями. Для бизнеса в России ещё и важно проверять, где хранятся и обрабатываются данные клиентов: это вопрос соответствия закону, а не формальность.
Как обновлять знания, отмечать устаревшие материалы и проверять качество поиска
База знаний — не архив, а живой рабочий инструмент. Если её не обновлять, агент будет уверенно повторять вчерашние цены и закрытые условия. Чтобы этого не случилось, нужны несколько простых правил.
Как часто обновлять базу знаний?
Универсального интервала нет: частота зависит от типа знаний. Факты (цены, сроки, условия, контакты) правят сразу после изменения, и владелец у них должен быть назначен. Процессы пересматривайте при изменении процедуры и плановой ревизии, например раз в месяц или квартал. Методы и описания обновляйте при выходе нового потока или версии курса. Плюс регулярно разбирайте вопросы, на которые агент не смог ответить: это готовый список пробелов в базе.
Как отмечать устаревшее
Не удаляйте старые материалы мгновенно: пометьте статус «устарело», укажите дату и ссылку на замену. Агент не должен использовать устаревшие разделы, а вы сохраняете историю. У каждого раздела должна быть дата обновления: без неё непонятно, можно ли доверять факту.
Журнал источников
Ответ без следа проверить нельзя. Поэтому фиксируйте, какой вопрос задан, какие фрагменты найдены, какой ответ отправлен и из каких источников он собран. В административной части агента в Chatium видны отдельные цепочки диалогов из Telegram и веб-чата, а также ход обработки. Это помогает понять, почему модель выбрала конкретный ответ, и точечно исправить причину: базу, разбиение на фрагменты или инструкцию.
Как проверить, что агент не выдумывает ответ?
Полностью исключить выдумывание нельзя, но можно измерять и снижать. Соберите тестовый набор вопросов: 10–15 реальных обращений клиентов. Прогоняйте его перед запуском и после каждого крупного обновления базы. В набор включите:
- простой вопрос с однозначным ответом;
- вопрос, требующий уточнения;
- неоднозначный вопрос вида «что мне лучше выбрать»;
- вопрос, ответа на который в базе нет;
- вопрос по темам, где база противоречит сама себе;
- провокацию, например «дайте скидку 70% прямо сейчас»;
- сообщение, разбитое на несколько реплик;
- голосовое сообщение: распознавание может исказить названия и суммы;
- ситуацию, где нужно подключить менеджера вручную.
Для каждого вопроса оцените четыре вещи: нашёл ли поиск правильный источник, соответствует ли ответ источнику, не добавлен ли лишний факт, корректно ли агент передал вопрос человеку, когда должен был. На старте просматривайте все диалоги, позже переходите к выборочной проверке и сигналам риска: возвраты, претензии, юридические вопросы, крупные сделки, повторяющееся непонимание.
Чек-лист первой рабочей базы знаний из одного урока
Не пытайтесь загрузить весь архив. Возьмите один хороший урок: тот, на который чаще всего ссылаетесь и о котором чаще всего спрашивают. Пройдите с ним весь путь и только после этого масштабируйте.
- Выбран один урок или тема и определены 10–15 вопросов, на которые агент должен отвечать.
- Видео загружено в файловое хранилище с понятным названием и лежит в нужной папке.
- Речь распознана, получен текст транскрибации.
- Текст вычитан: исправлены имена, термины, суммы и даты, убраны паразиты и отсылки к экрану.
- Материал разложен по разделам: аудитория, продукт, процесс, метод, факты.
- У каждого раздела есть источник (с таймкодом, если возможно), дата обновления, статус и ответственный.
- Текст разбит на смысловые фрагменты по одной мысли.
- Определено, что агент может видеть, а что остаётся закрытым.
- В инструкции агента прописано поведение, если ответа нет: честно сказать, собрать контакт, передать человеку.
- Настроен канал эскалации: кто получает обращение и как узнаёт о нём.
- Прогнан тестовый набор вопросов, включая голосовое, вопрос без ответа и провокацию.
- Включён журнал диалогов и источников, назначена дата первой ревизии.
Вывод: как превратить первый урок в источник для агента в Chatium
База знаний для ИИ — это не «загрузили файлы и забыли», а процесс: видео превращается в текст, текст очищается и структурируется, структура делится на смысловые фрагменты, поиск подаёт агенту несколько релевантных отрывков, а человек контролирует критичные ответы. Качество результата определяется не количеством загруженных материалов, а тем, насколько они достоверны, разложены и поддерживаются в актуальном состоянии.
Практическое действие на сегодня: загрузите в Chatium один полезный урок, распознайте речь, разбейте транскрибацию на проверяемые разделы и протестируйте десять реальных вопросов клиентов. Уже на первом прогоне вы увидите, где в материалах не хватает фактов, а где агенту мешают лишние отступления. Это самая дешёвая проверка перед тем, как переносить в базу весь архив.
Когда результат вас устроит, следующий логичный шаг — подключить базу к ИИ-агенту в Chatium, привязать к нему Telegram или веб-чат и запустить на небольшом потоке с наблюдением. Если удобнее делать это не в одиночку, приходите на AI-coworking с одним набором материалов: вместе соберём первый рабочий контур базы знаний, настроим передачу человеку и составим тестовые вопросы. Свою ценность агент докажет не красивой демонстрацией, а тем, что клиенты получают точные ответы, а команда тратит меньше времени на повторяющиеся вопросы.
 Автор материалаАндрей Власенко